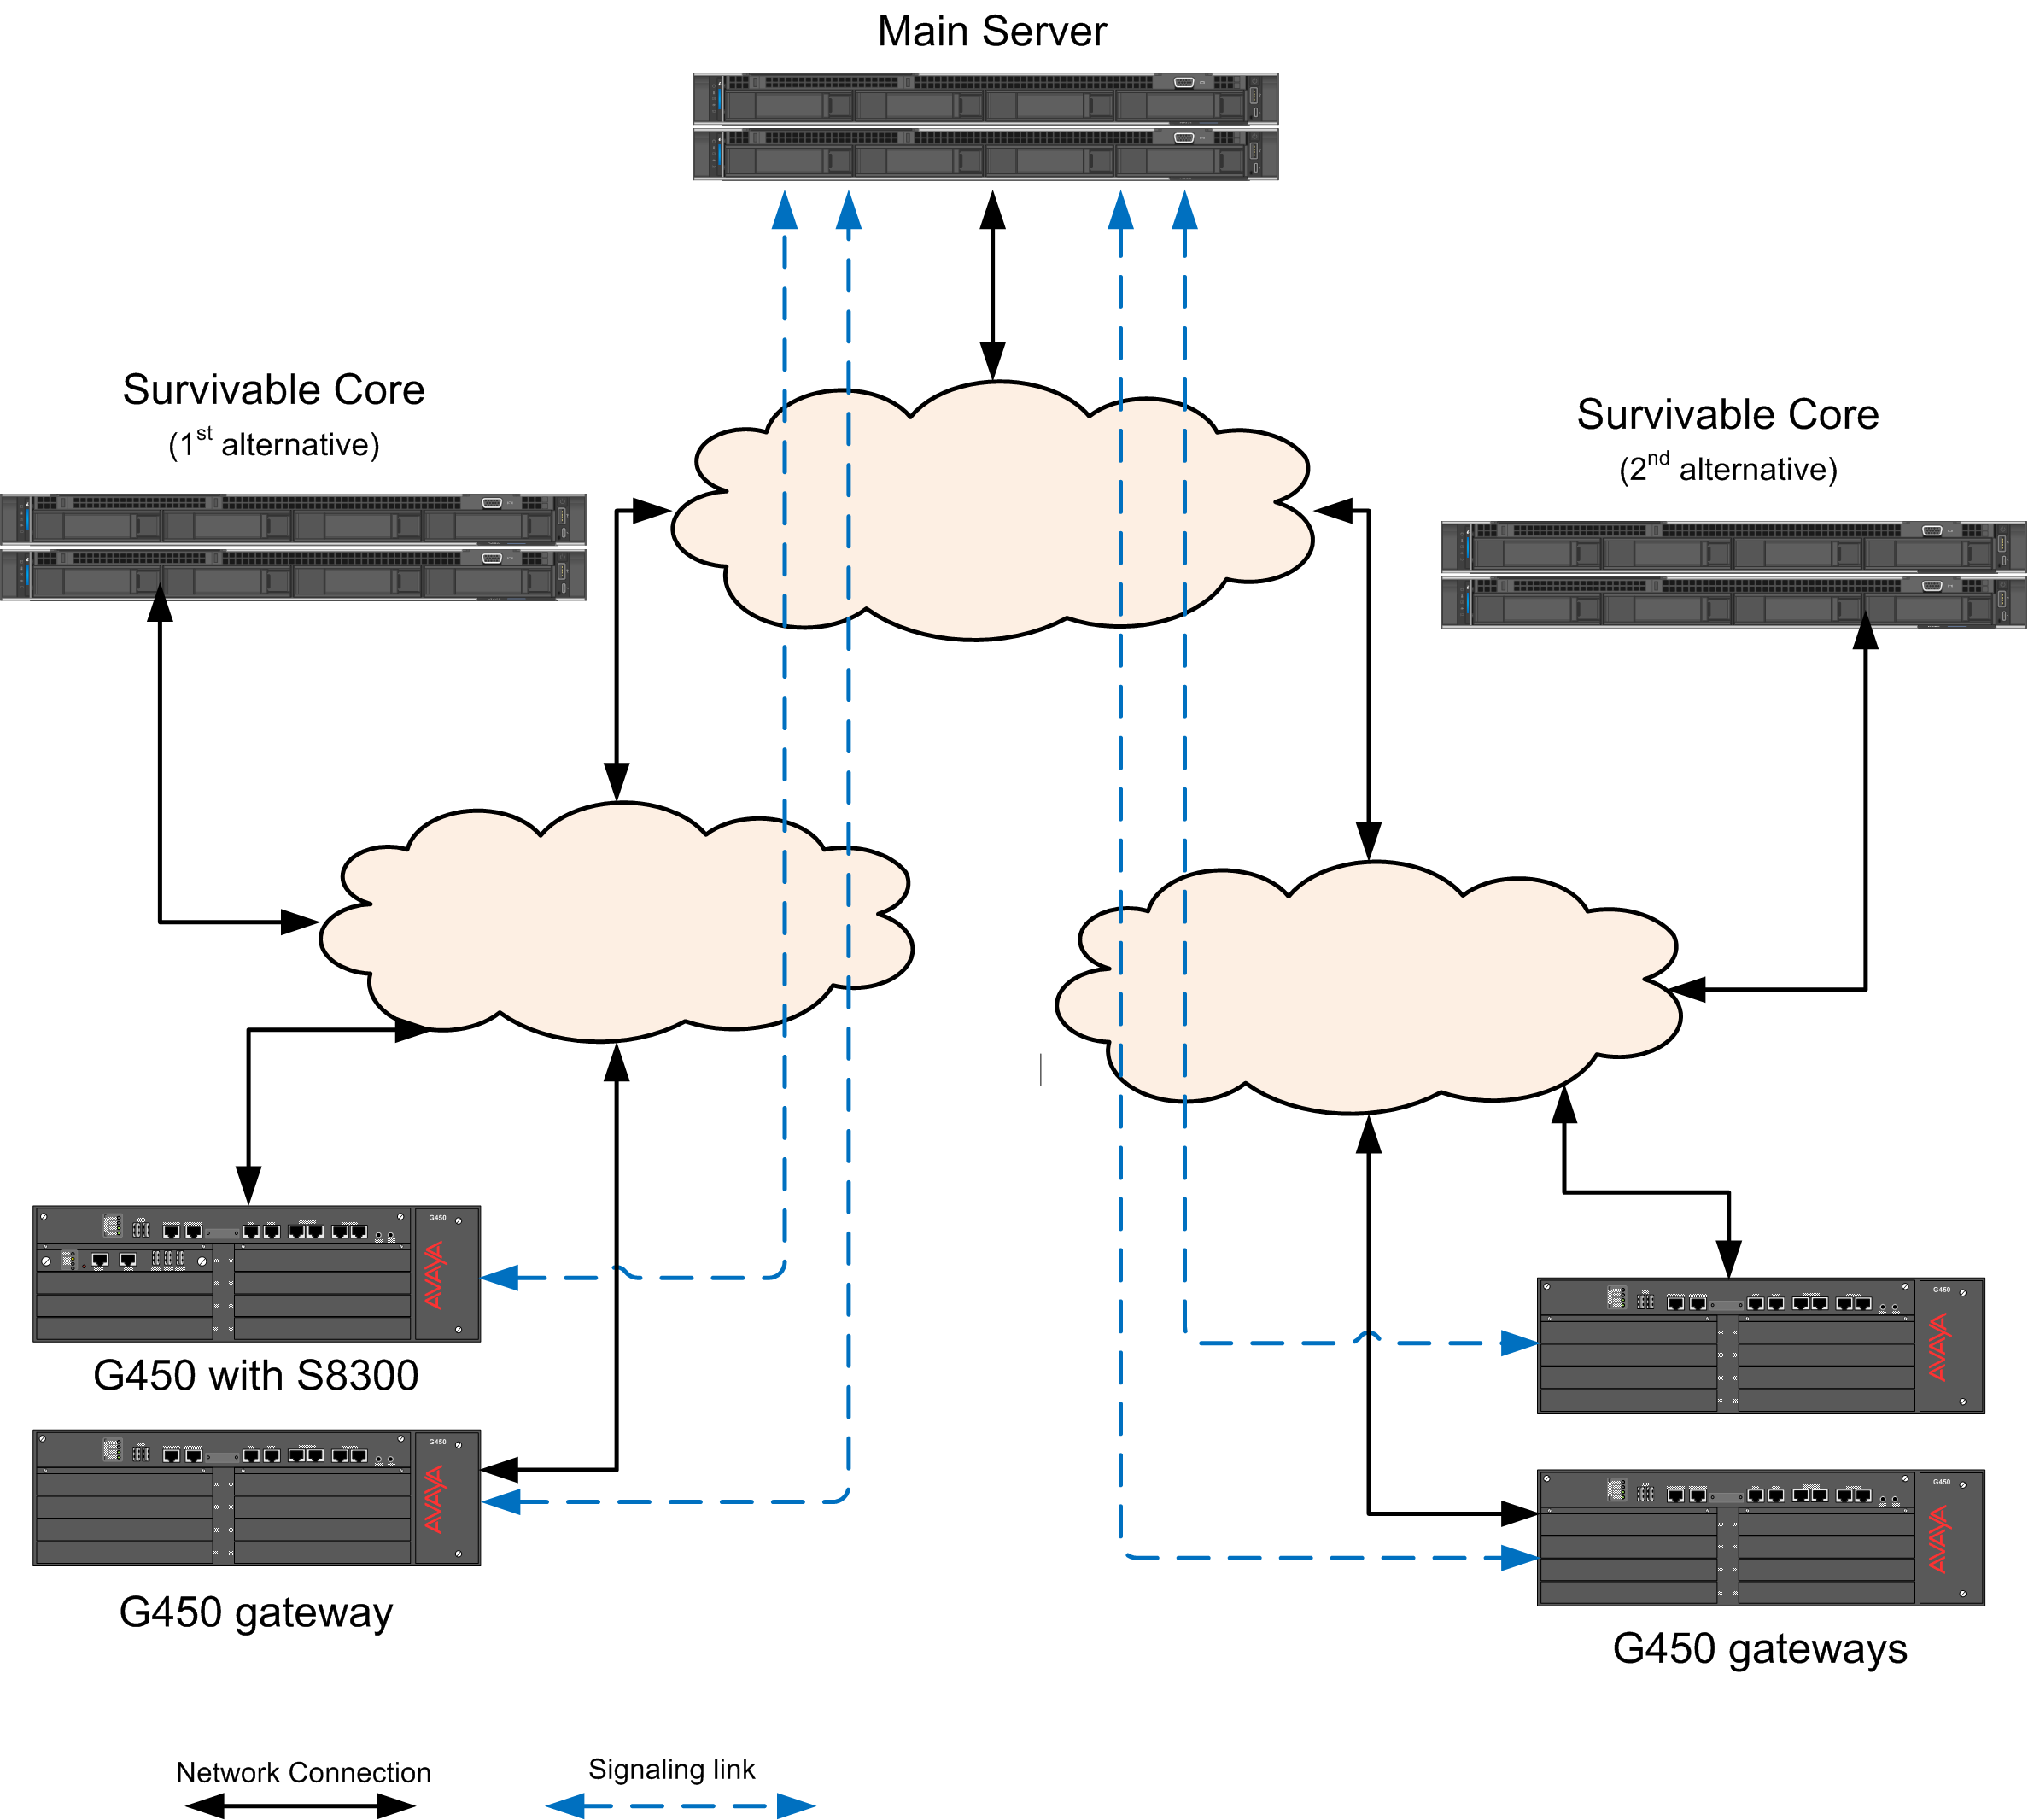
L'exemple deux utilise la même configuration que celle utilisée dans l'exemple deux. Le serveur S8300E est le serveur principal, avec deux serveurs centraux survivables S8300E (première alternative et deuxième alternative). En raison d'une défaillance catastrophique, le serveur principal est hors service. Toutes les passerelles multimédia sont maintenant contrôlées par le 1er serveur principal surviable alternatif.
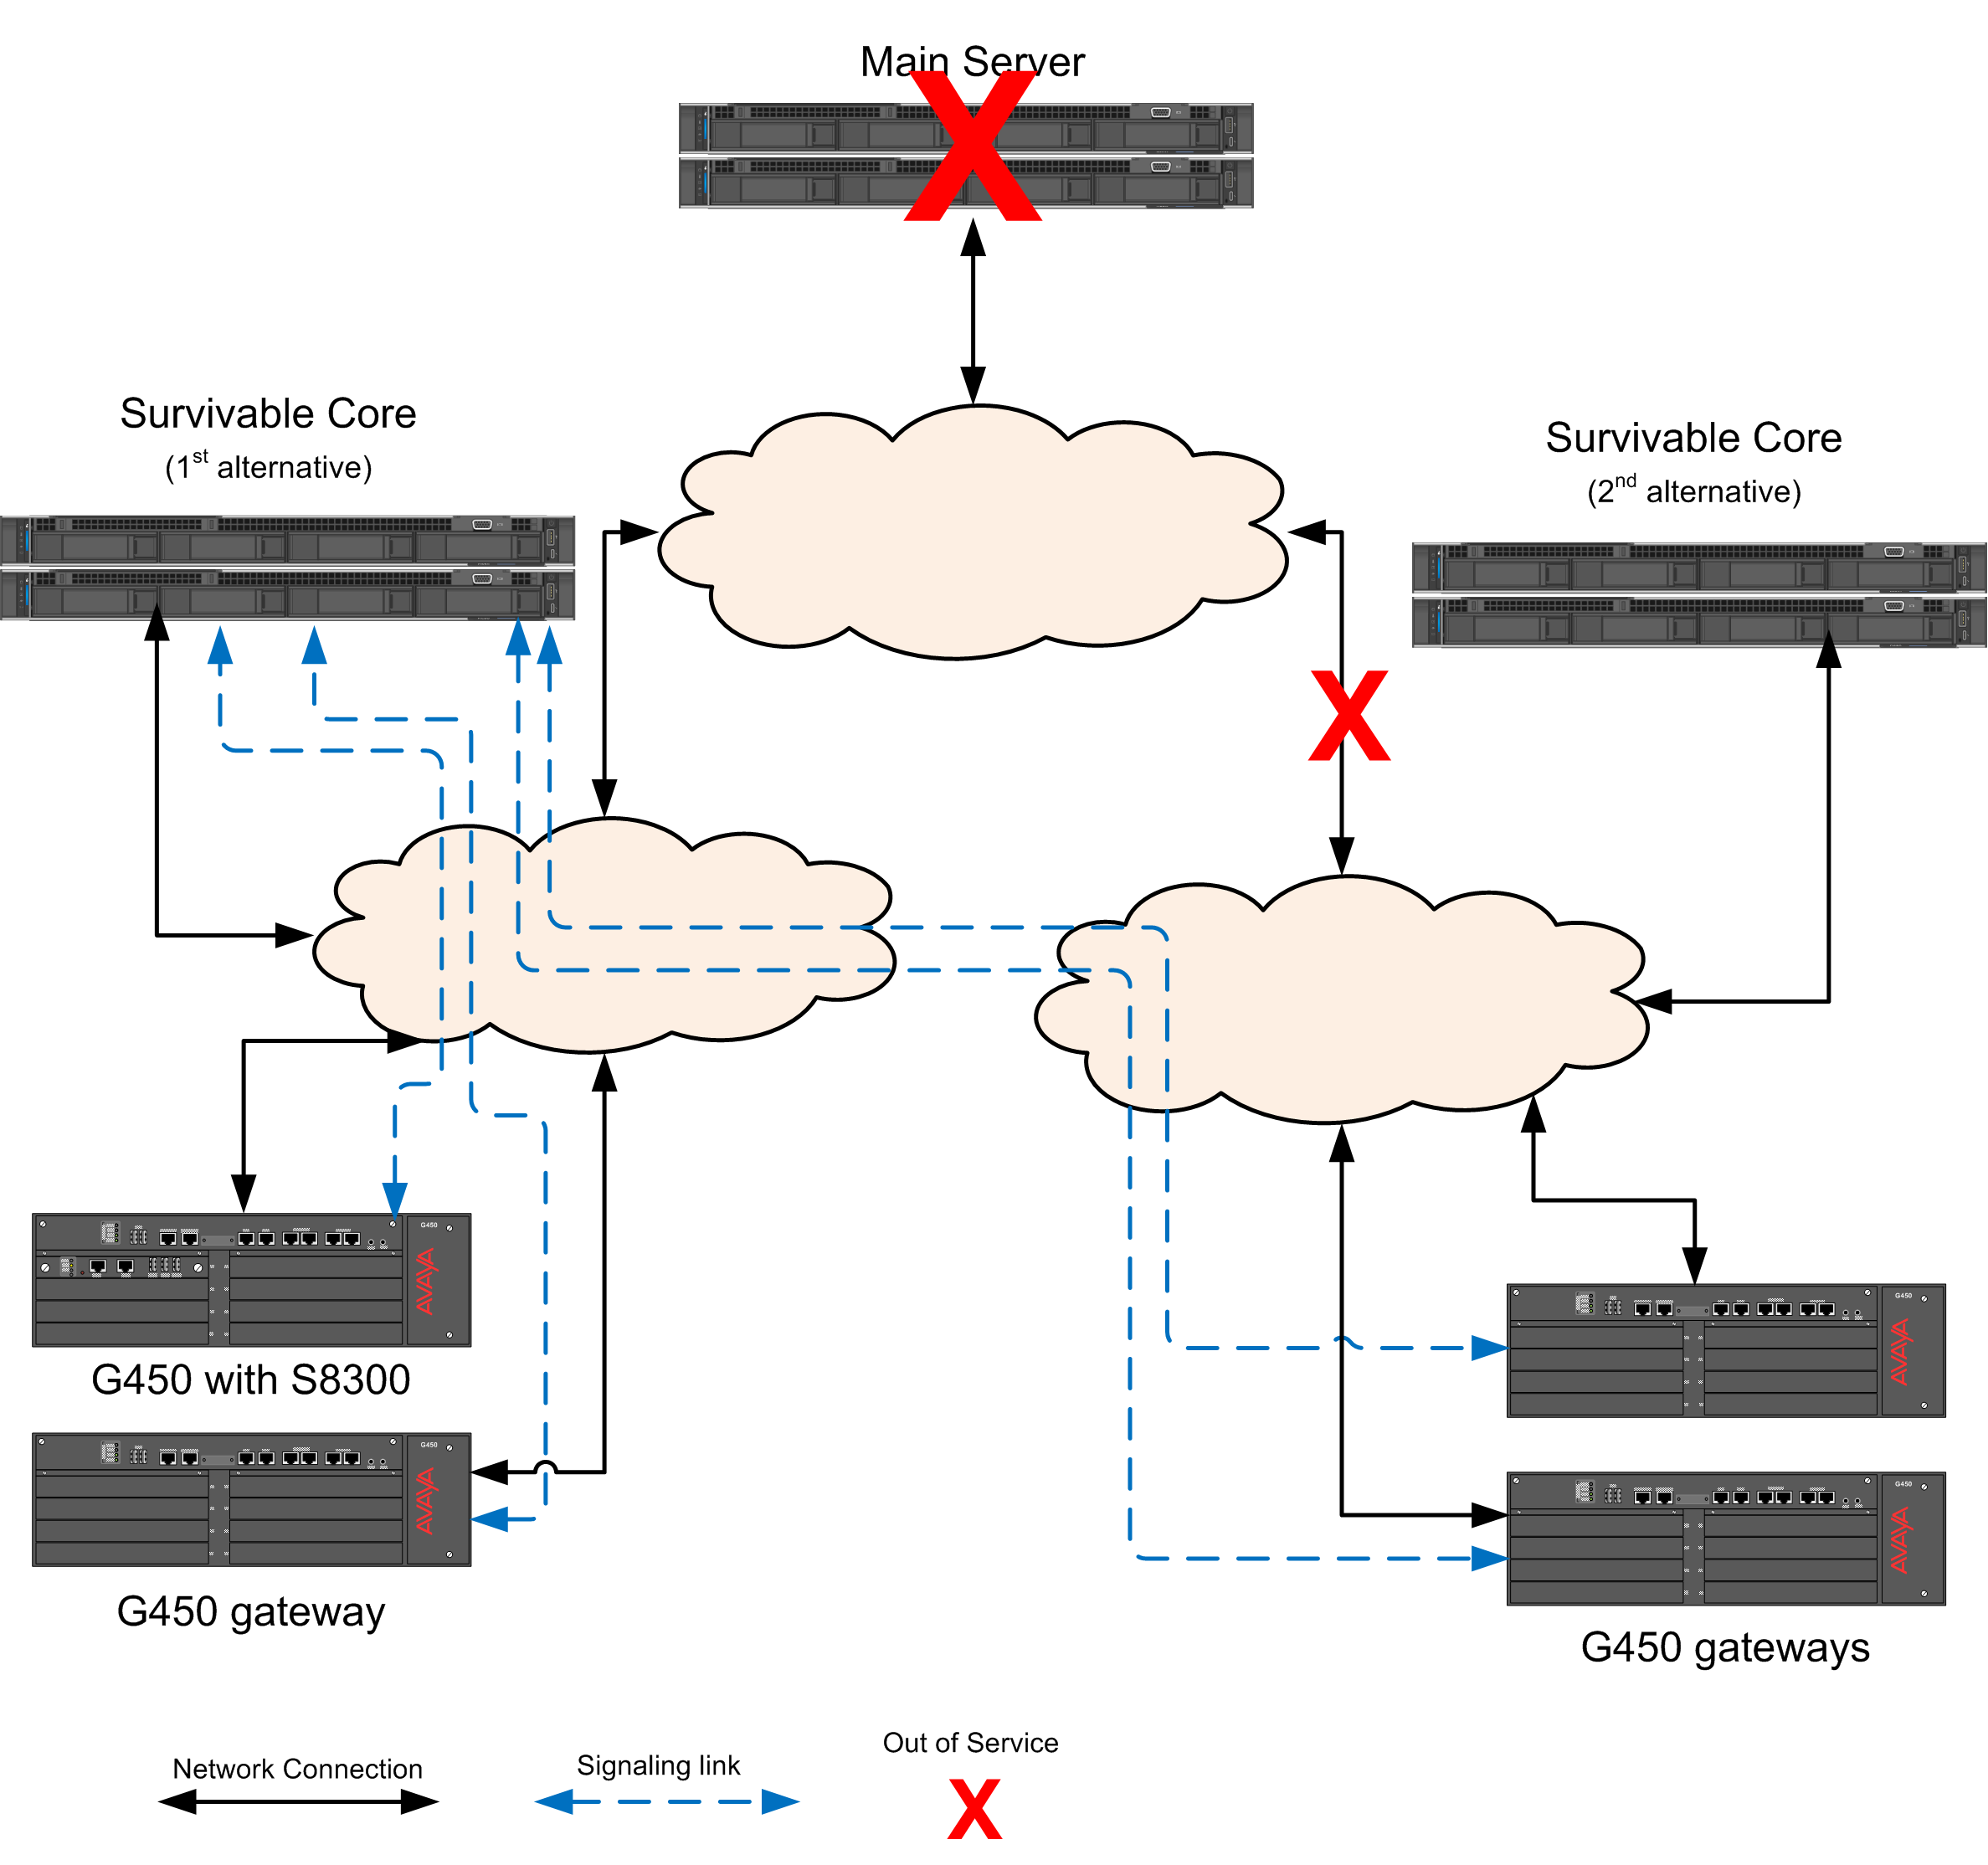
À ce stade, il s'agit du même scénario que dans l'exemple un. Désormais, le client subit une panne du réseau entraînant une fragmentation du réseau (voir Figure 4 : Fragmentation du réseau). Les passerelles média trois et quatre peuvent communiquer avec le deuxième serveur central surviable alternatif, mais ne peuvent plus communiquer avec le serveur central ou le premier serveur central surviable alternatif. Les passerelles média un et deux peuvent toujours communiquer avec le premier serveur de cœur surviable alternatif, mais ne peuvent plus communiquer avec le deuxième serveur de cœur surviable alternatif.
Illustration Échec de la fragmentation du réseau
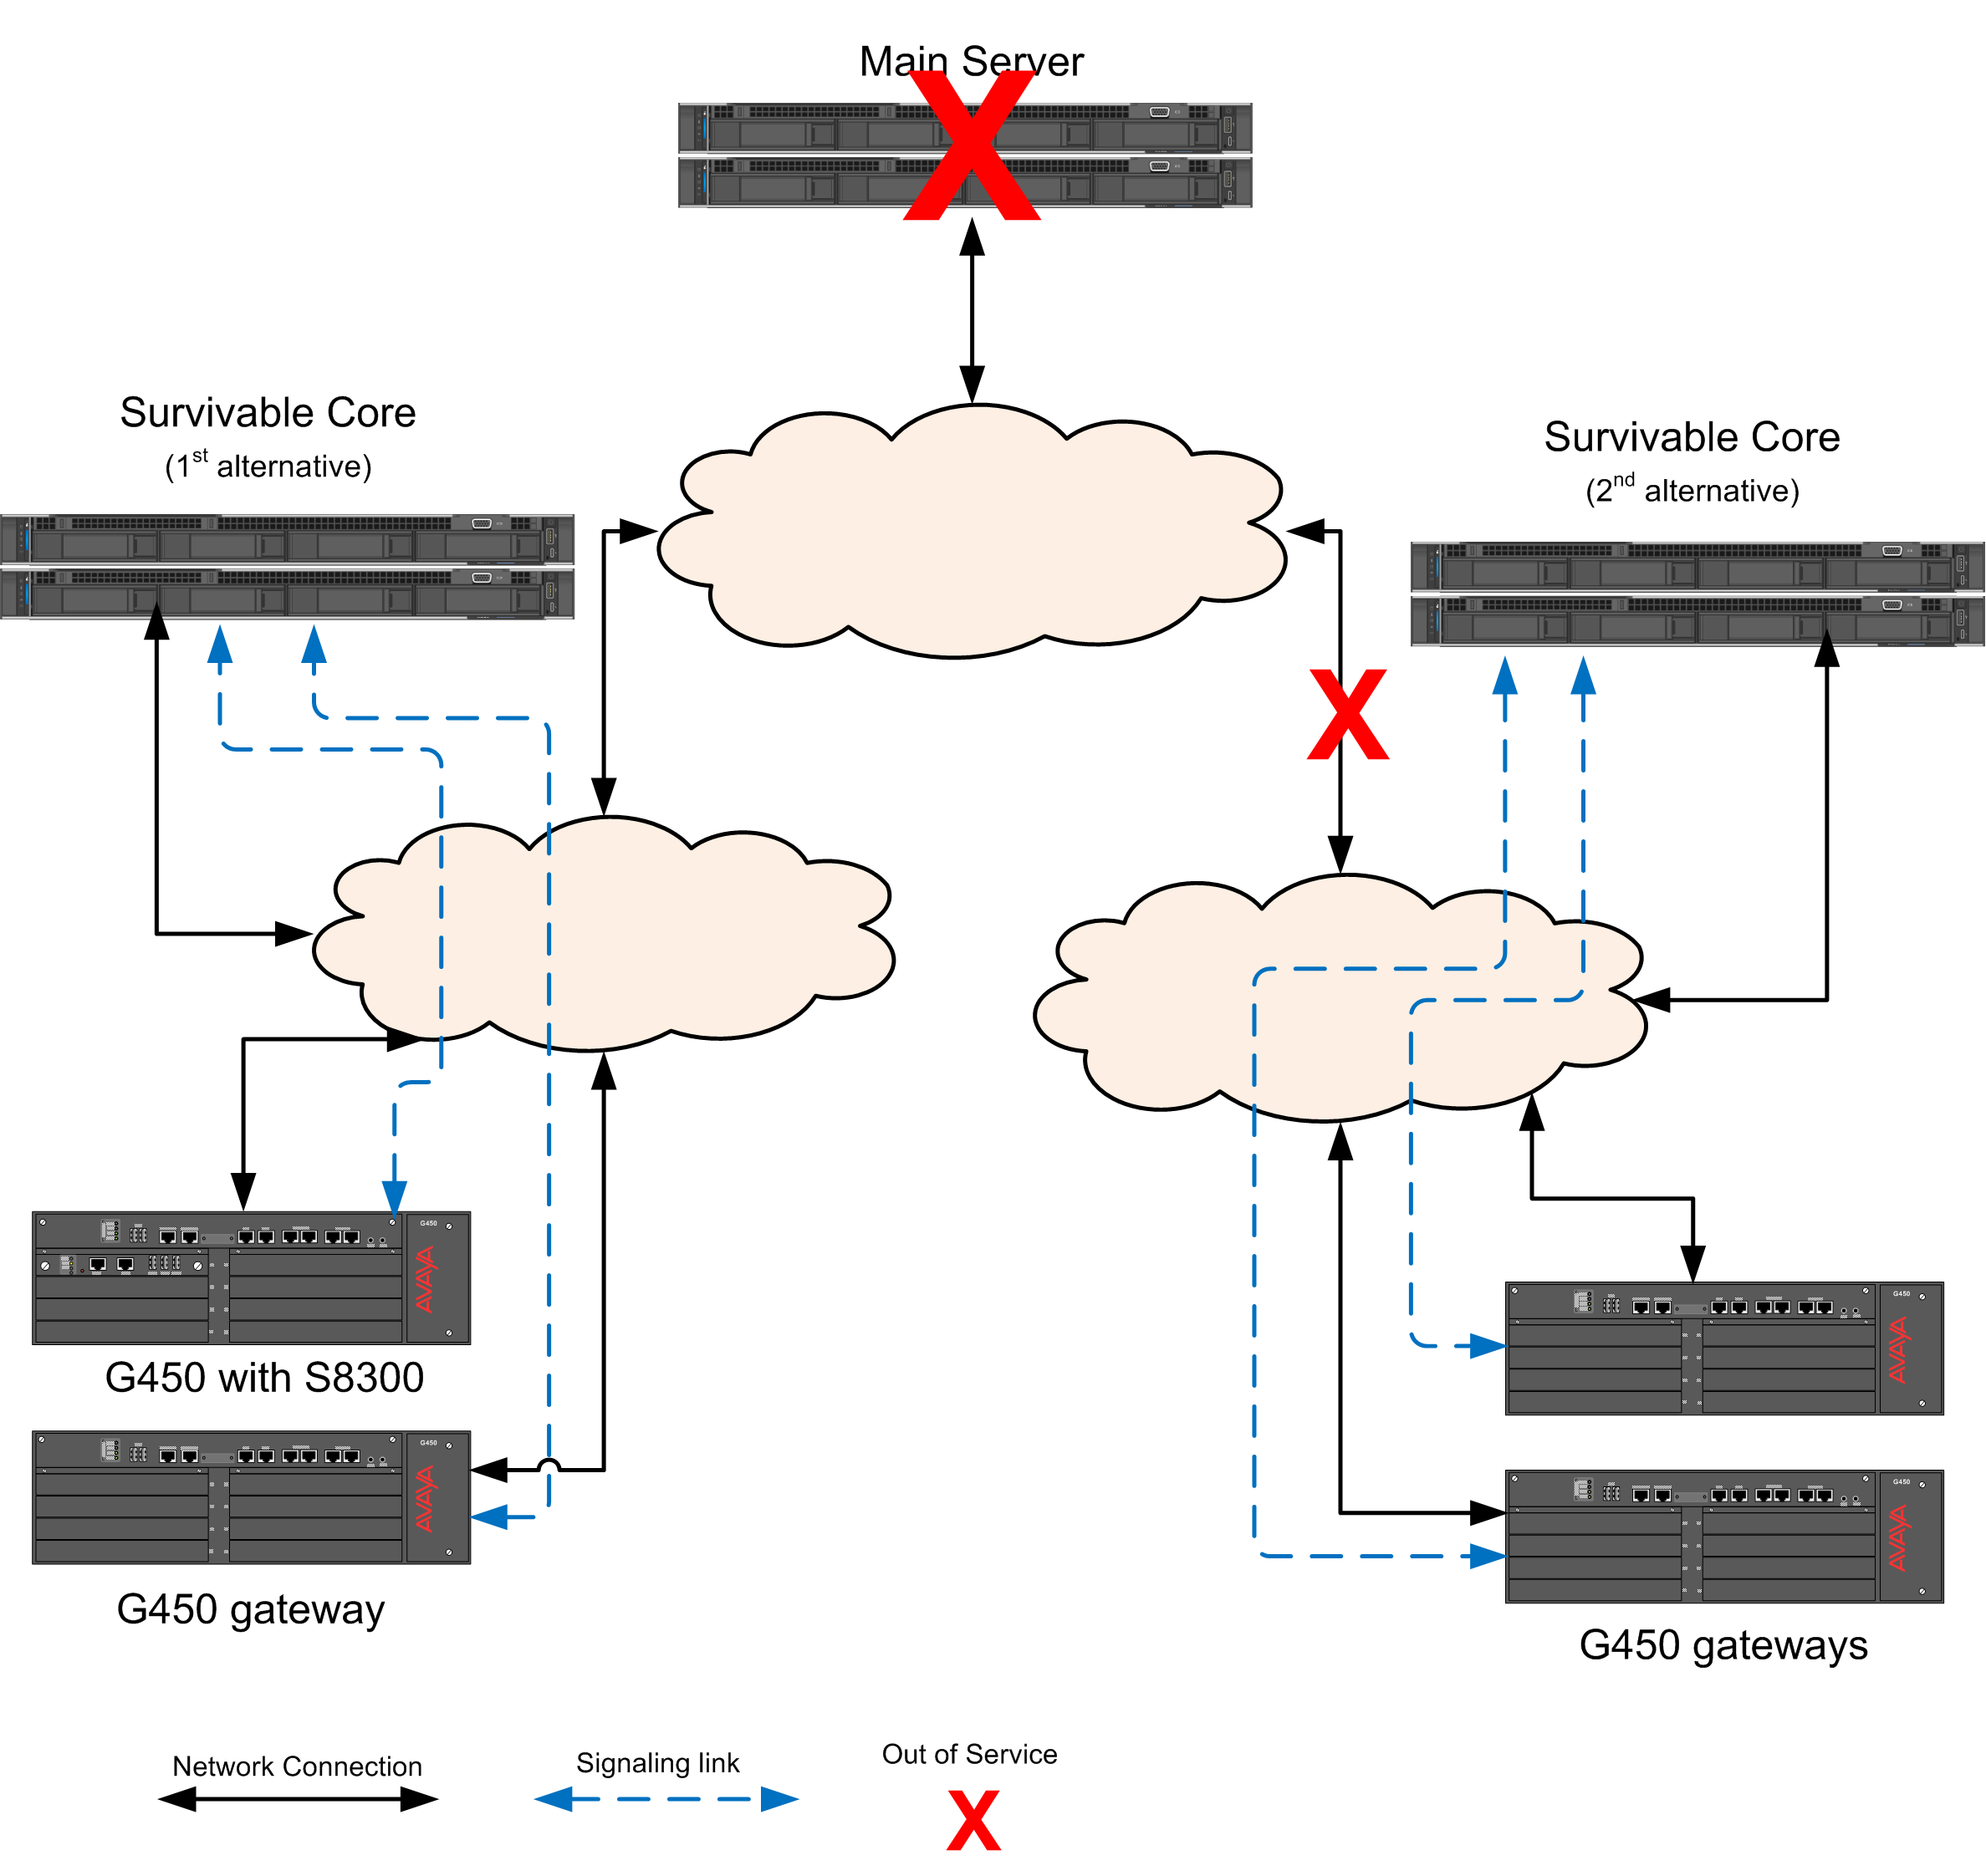
Étant donné que les passerelles multimédia trois et quatre ne peuvent plus communiquer avec le serveur principal ou le premier serveur alternatif, elles ajustent leur liste de priorités et déplacent le deuxième serveur alternatif en haut de la liste. Le deuxième serveur alternatif accuse réception de la demande et prend le contrôle des passerelles trois et quatre (voir Figure 5 : Défaillance du réseau - Récupération du serveur principal survivable). Veuillez noter que les passerelles multimédias 1 et 2 n'ont connu aucune panne de service en raison de la défaillance.
Illustration Panne réseau - Récupération du serveur central survivable
Les utilisateurs des passerelles un à quatre vivent les expériences suivantes :
Pendant l'intervalle de minuterie de recherche principal :
Les appels stables restent dans l'état dans lequel ils se trouvaient avant la panne. Les appels stables n'ont pas accès aux fonctionnalités telles que la mise en attente, la conférence, etc. L'état de l'appel stable ne peut pas être modifié.
Les utilisateurs qui tentent d'établir un appel téléphonique ne reçoivent pas de tonalité.
Les appels entrants au système reçoivent une tonalité d’occupation rapide (tonalité de réorganisation) ou une annonce du fournisseur de services indiquant que toutes les liaisons sont occupées.
Après l'expiration du minuteur de recherche principal :
Pour les utilisateurs d'un appel téléphonique connecté par IP, les appels IP mélangés restent actifs. Une fois l'appel terminé, l'utilisateur du téléphone IP ne peut pas faire un autre appel tant que le téléphone IP n'est pas réenregistré auprès d'un portier.
Les appels sur les téléphones DCP ou analogiques sont interrompus.
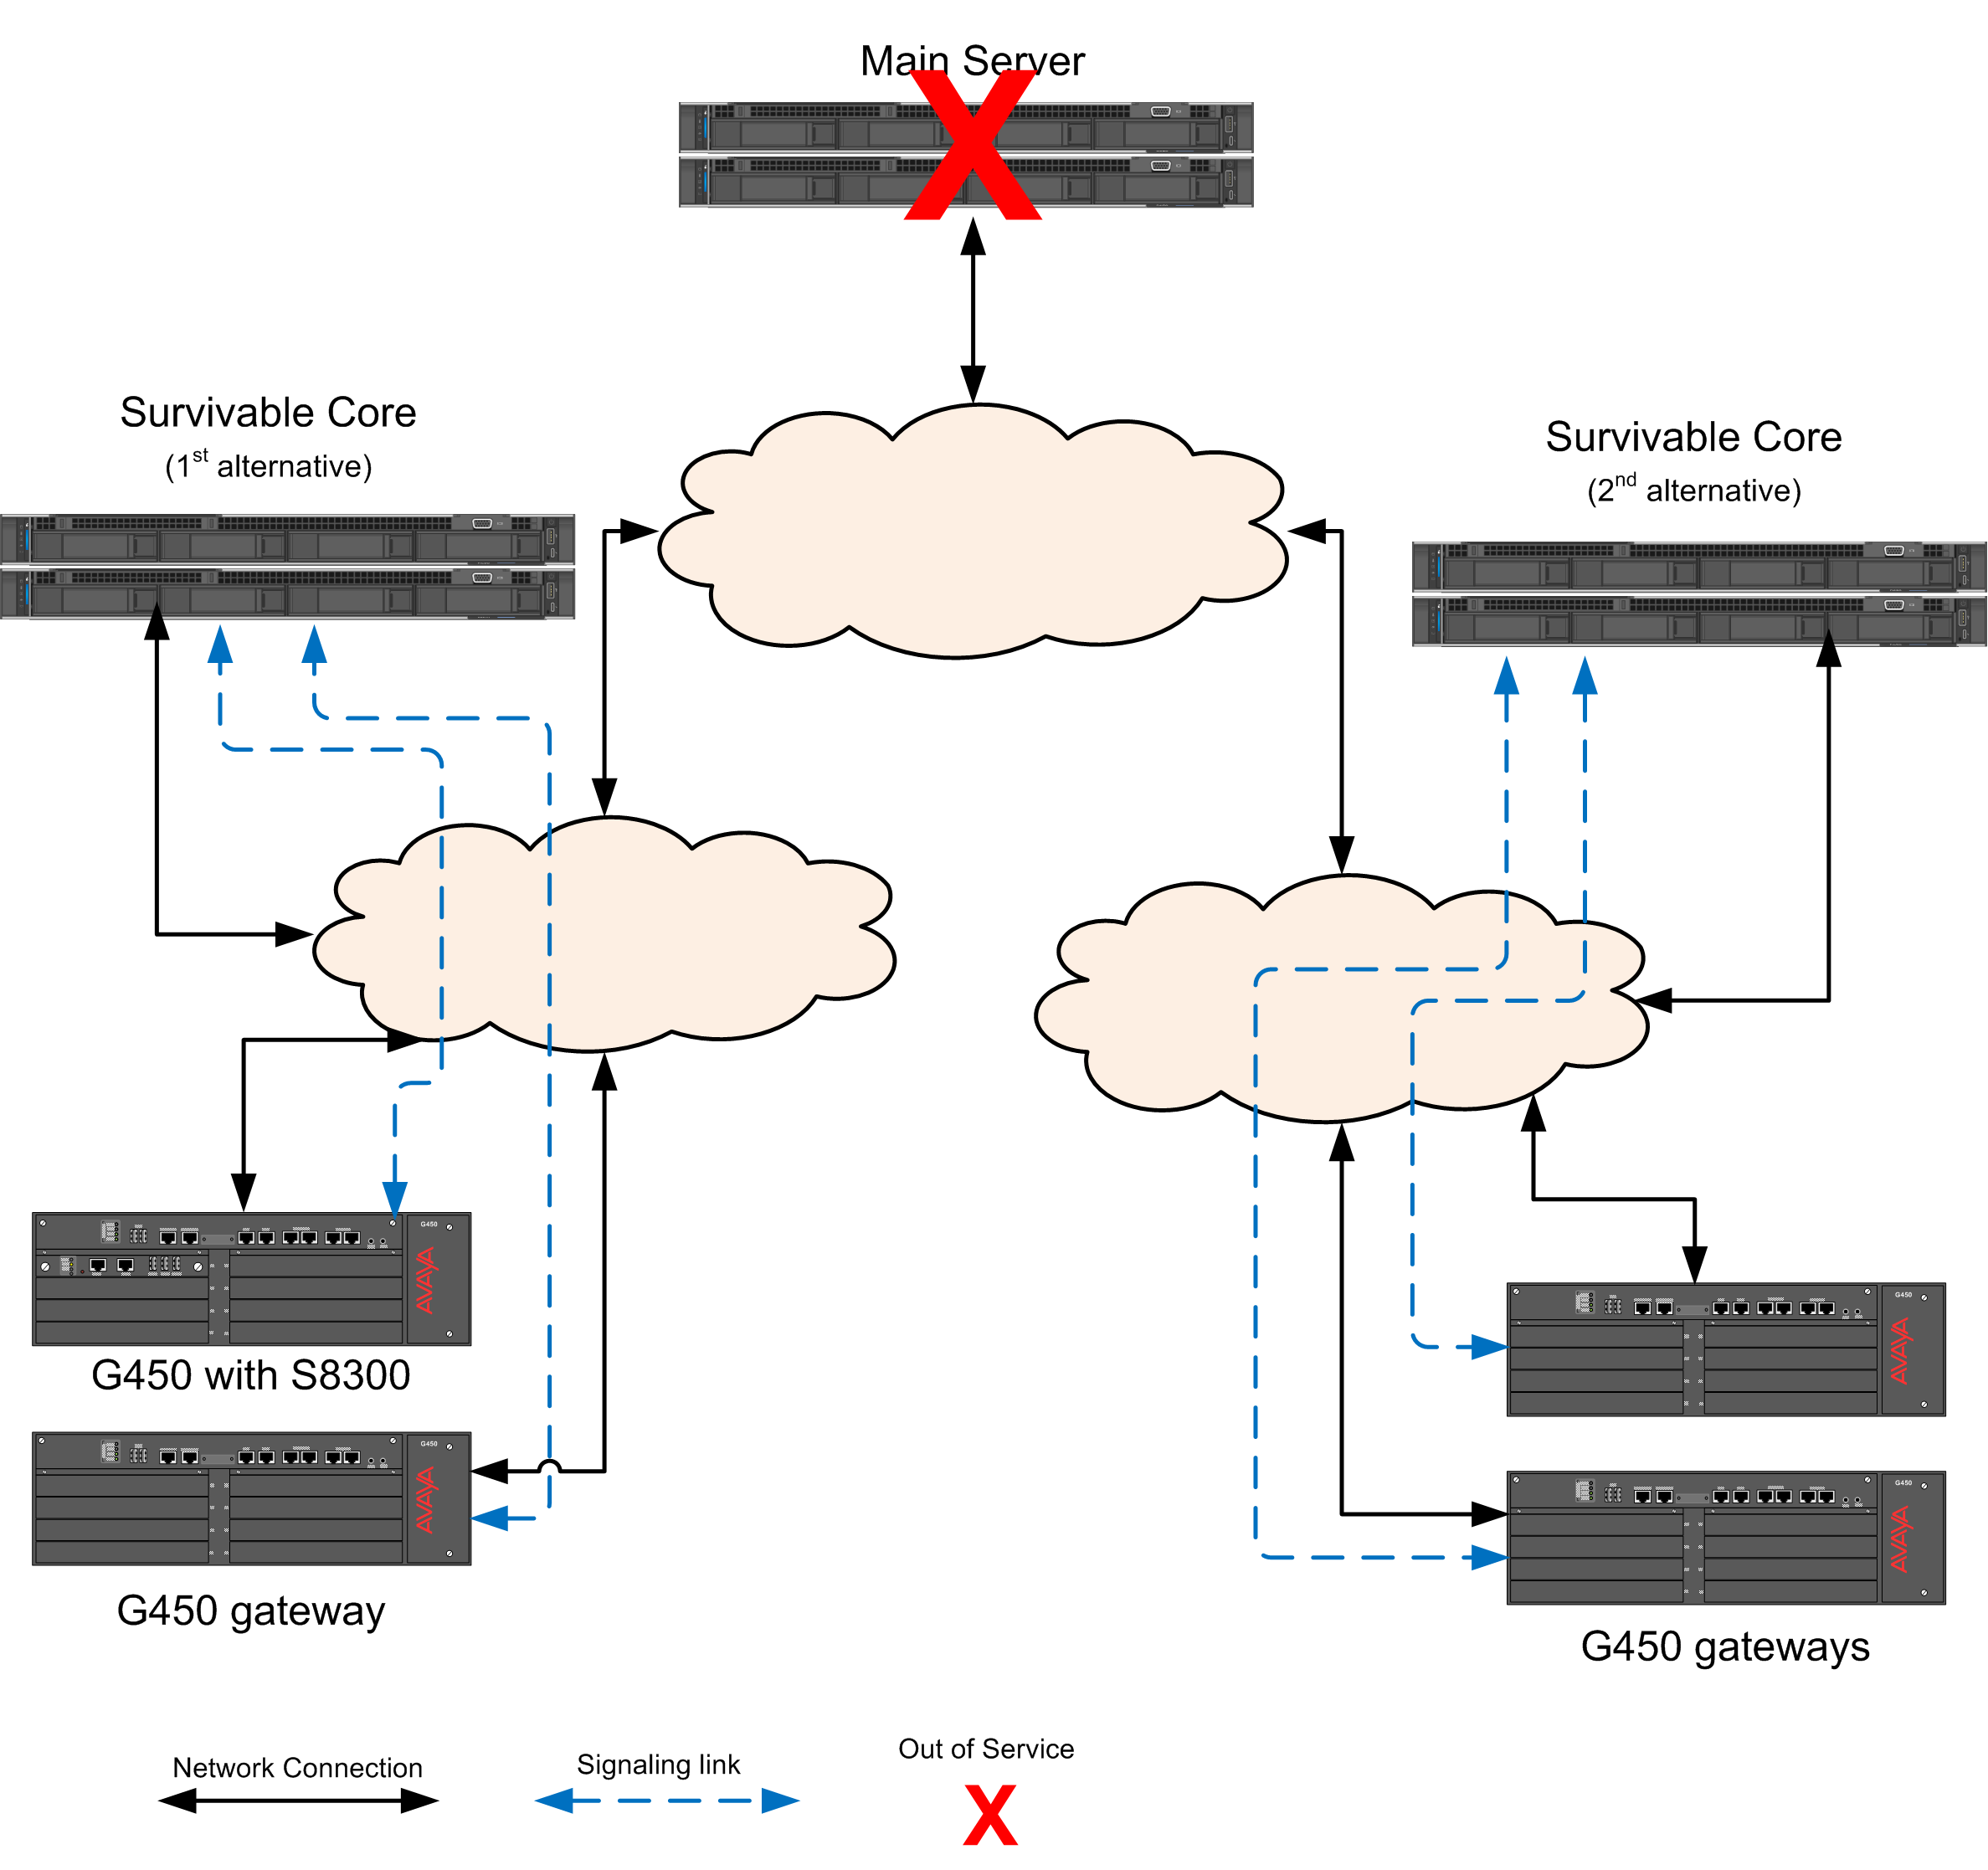
Le client est maintenant en train de récupérer de la défaillance du réseau et de la défaillance du serveur principal (voir Figure 6 : Récupération de la défaillance du réseau). À mesure que la défaillance du réseau est corrigée, les passerelles multimédias trois et quatre peuvent maintenant communiquer avec le premier serveur. Les passerelles ne retournent pas automatiquement sous le contrôle du premier serveur secondaire. Les passerelles tentent toujours de revenir au contrôleur principal. Le retour au mode principal est défini par la règle de récupération configurée pour chaque passerelle dans le formulaire d'ajout/changement de passerelle multimédia. Le retour au poste principal peut être réglé pour une certaine heure de la journée ou un jour de la semaine, lorsqu'aucun appel n'est en cours, ou peut être configuré pour être immédiat. Le retour au poste principal peut également être réglé sur manuel à l'aide de l'option « aucune règle ». Dans ce cas, les passerelles ne retournent au poste principal que lorsque l'administrateur émet une commande enable mg-return.
Illustration Récupération de la fragmentation du réseau
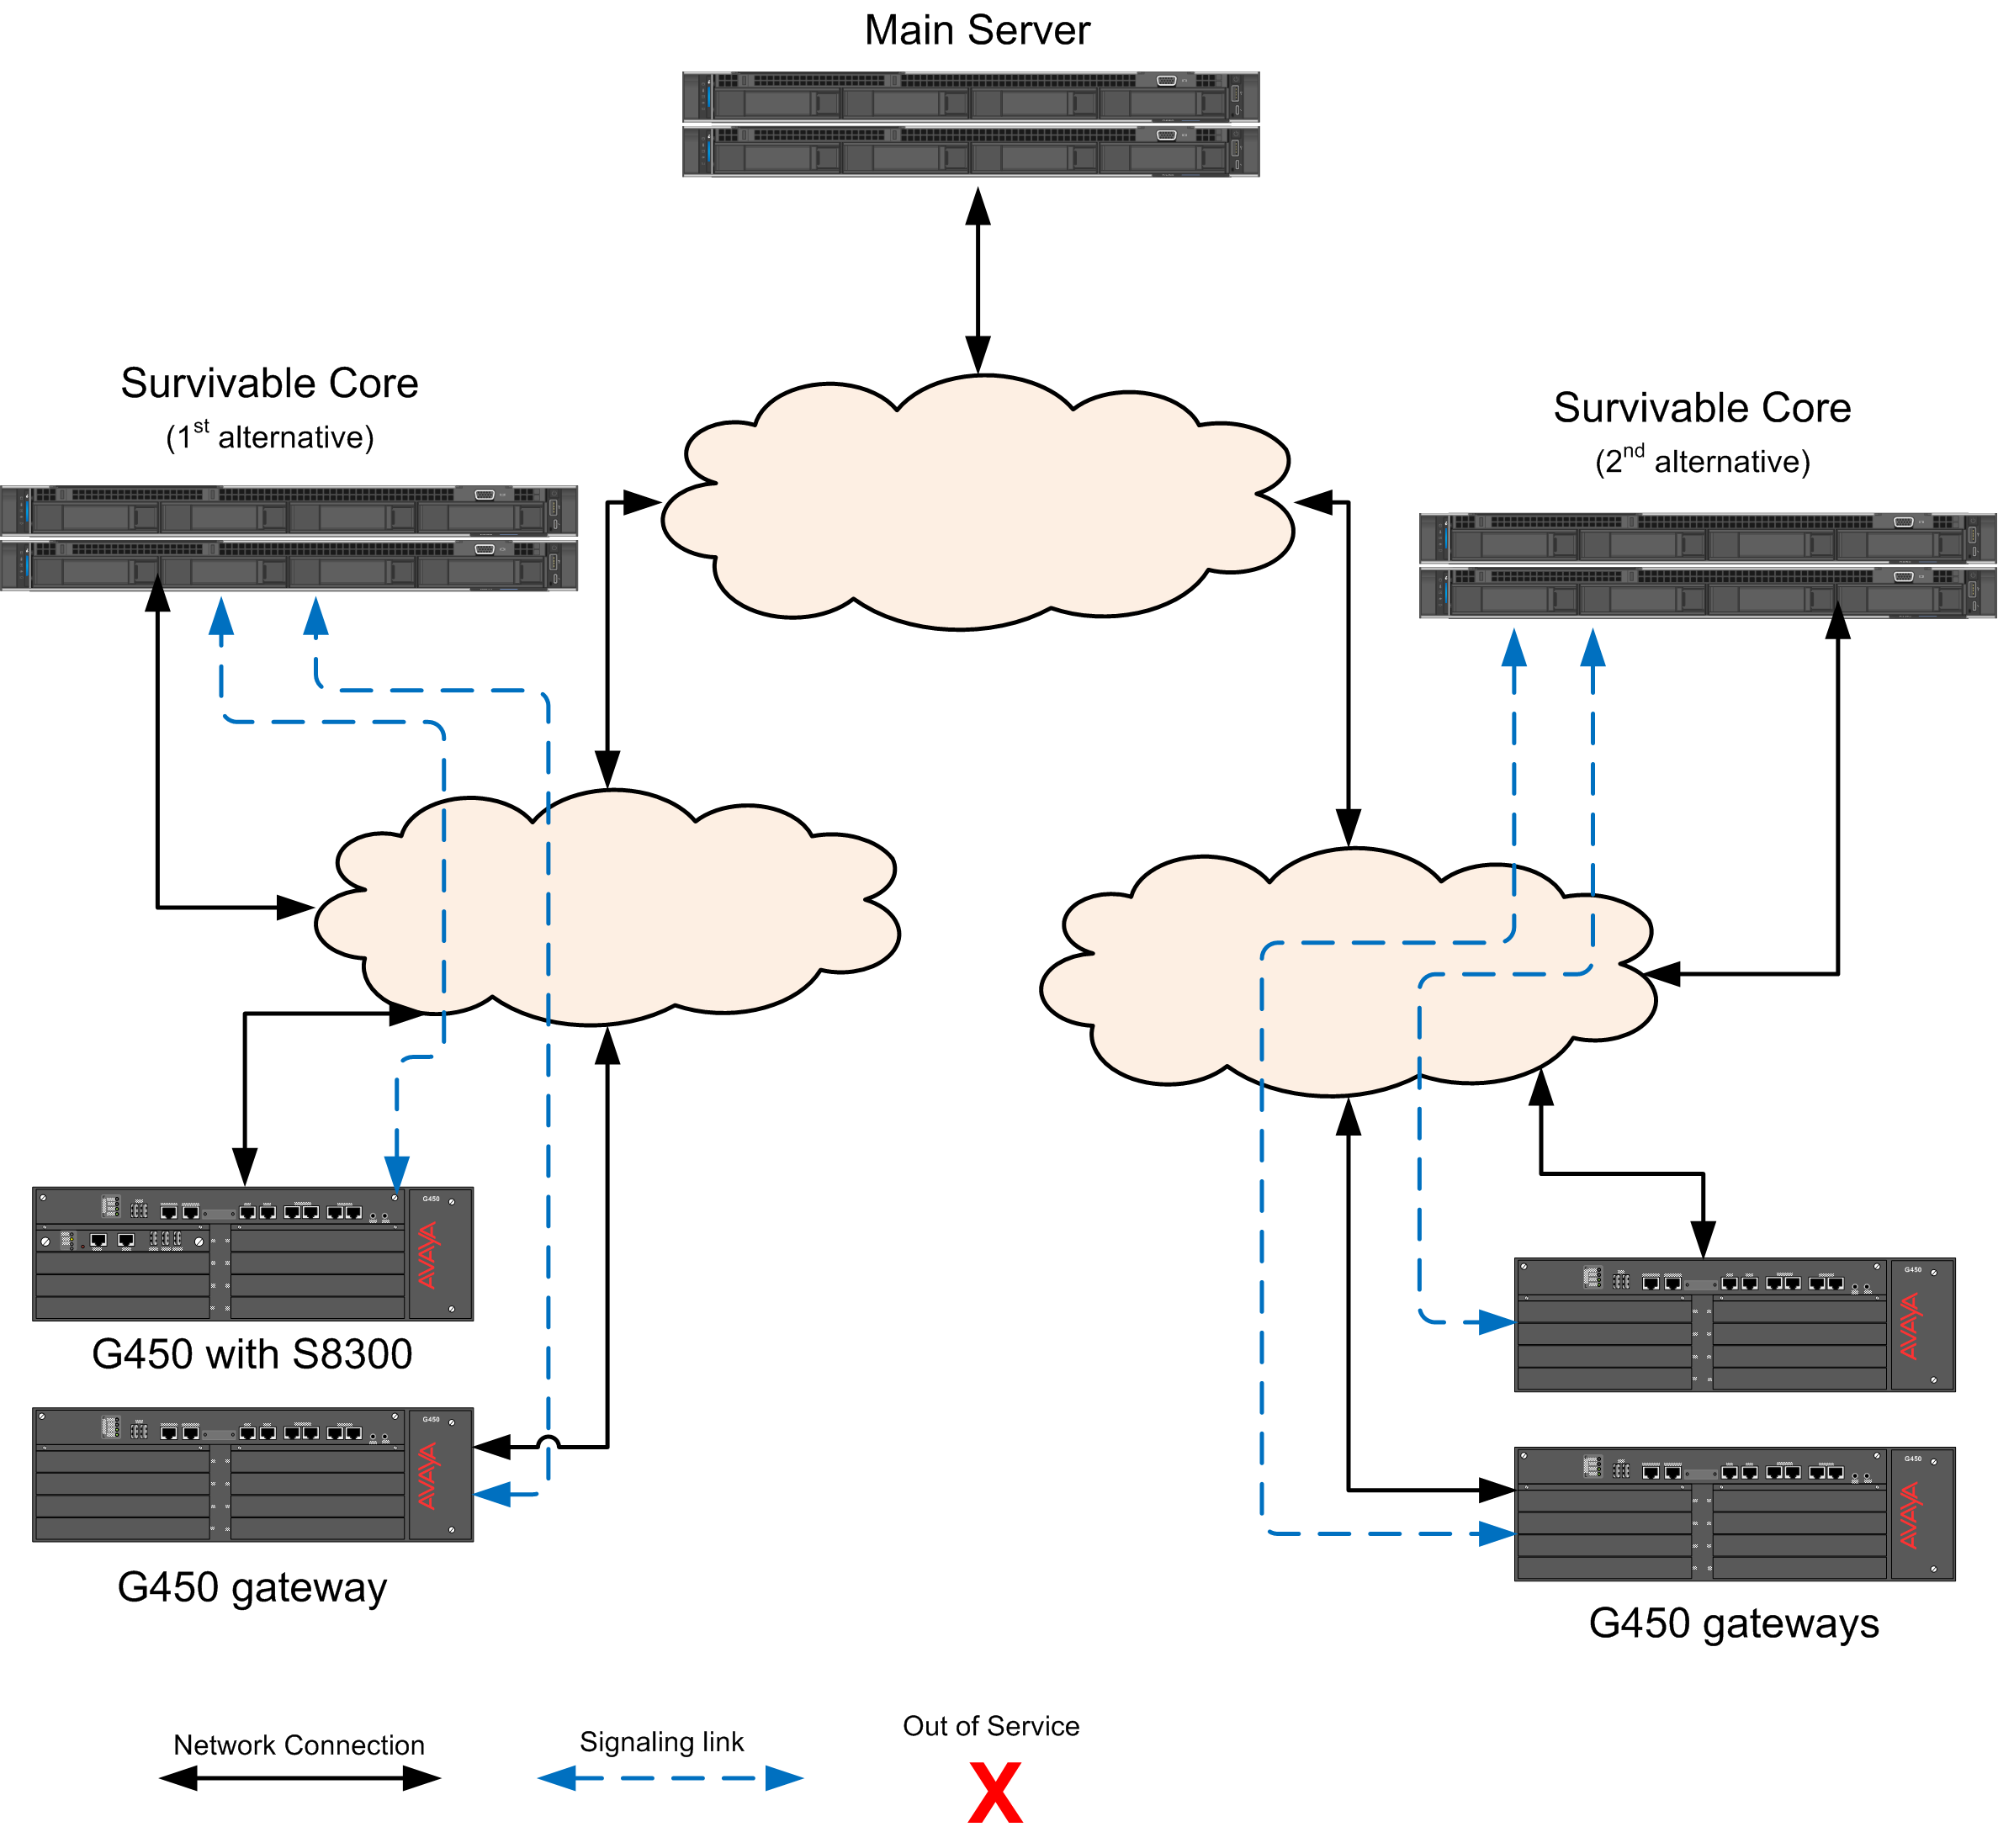
Le serveur principal est maintenant restauré (voir Figure 7 : Récupération du serveur principal). Les passerelles multimédia peuvent maintenant communiquer avec le serveur principal et chaque serveur survivable. Le serveur principal est toujours la priorité la plus élevée sur toute liste de priorité de passerelle multimédia.
Illustration Récupération du serveur principal
Le retour au principal est défini par la règle de récupération configurée pour chaque passerelle dans le formulaire d'ajout/modification de passerelle multimédia. Le retour au poste principal peut être réglé pour une certaine heure de la journée ou un jour de la semaine, lorsqu'aucun appel n'est en cours, ou peut être configuré pour être immédiat. Le retour au poste principal peut également être réglé sur manuel sans règle ; dans ce cas, les passerelles ne retournent au poste principal que lorsque l'administrateur émet une commande enable mg-return.
Illustration Serveur distant résilient fonctionnant dans un environnement de serveur principal résilient - fonctionnement normal